为了增加pipeline的运算速度,所以利用集群来进行日志的分析统计。测试数据规模:某机构edX的D版在真实场景下一年多使用记录。
开始日期 2016/11/27
开始时间 2:26:00
结束日期 2016/11/28
结束时间 3:34:00
总时间 23:10:54
日志开始日期 2015/6/7
日志结束日
More.....
为了增加pipeline的运算速度,所以利用集群来进行日志的分析统计。测试数据规模:某机构edX的D版在真实场景下一年多使用记录。
开始日期 2016/11/27
开始时间 2:26:00
结束日期 2016/11/28
结束时间 3:34:00
总时间 23:10:54
日志开始日期 2015/6/7
日志结束日
本次搭建CDH主要用于edX的数据分析,用于安装pipeline加快运算速度。
3+N结构,3台主机负责HDFS主节点、CDH自身服务、YARN的ResourceManager等主要服务。 其他N台负责HDFS的NameNode和YARN的NodeManager,承担计算任务。现初步设计为6台、即3+3
CPU:双核E5
计科的同学做实验如果需要分词可以试用下这个分词引擎。
github地址https://github.com/huaban/elasticsearch-analysis-jieba
es官方文档https://www.elastic.co/guide/en/elasticsearch/reference/2.3/getting-started.html
地址http://es.hylstudio.cn/jieba
接口说明
返回json中的index
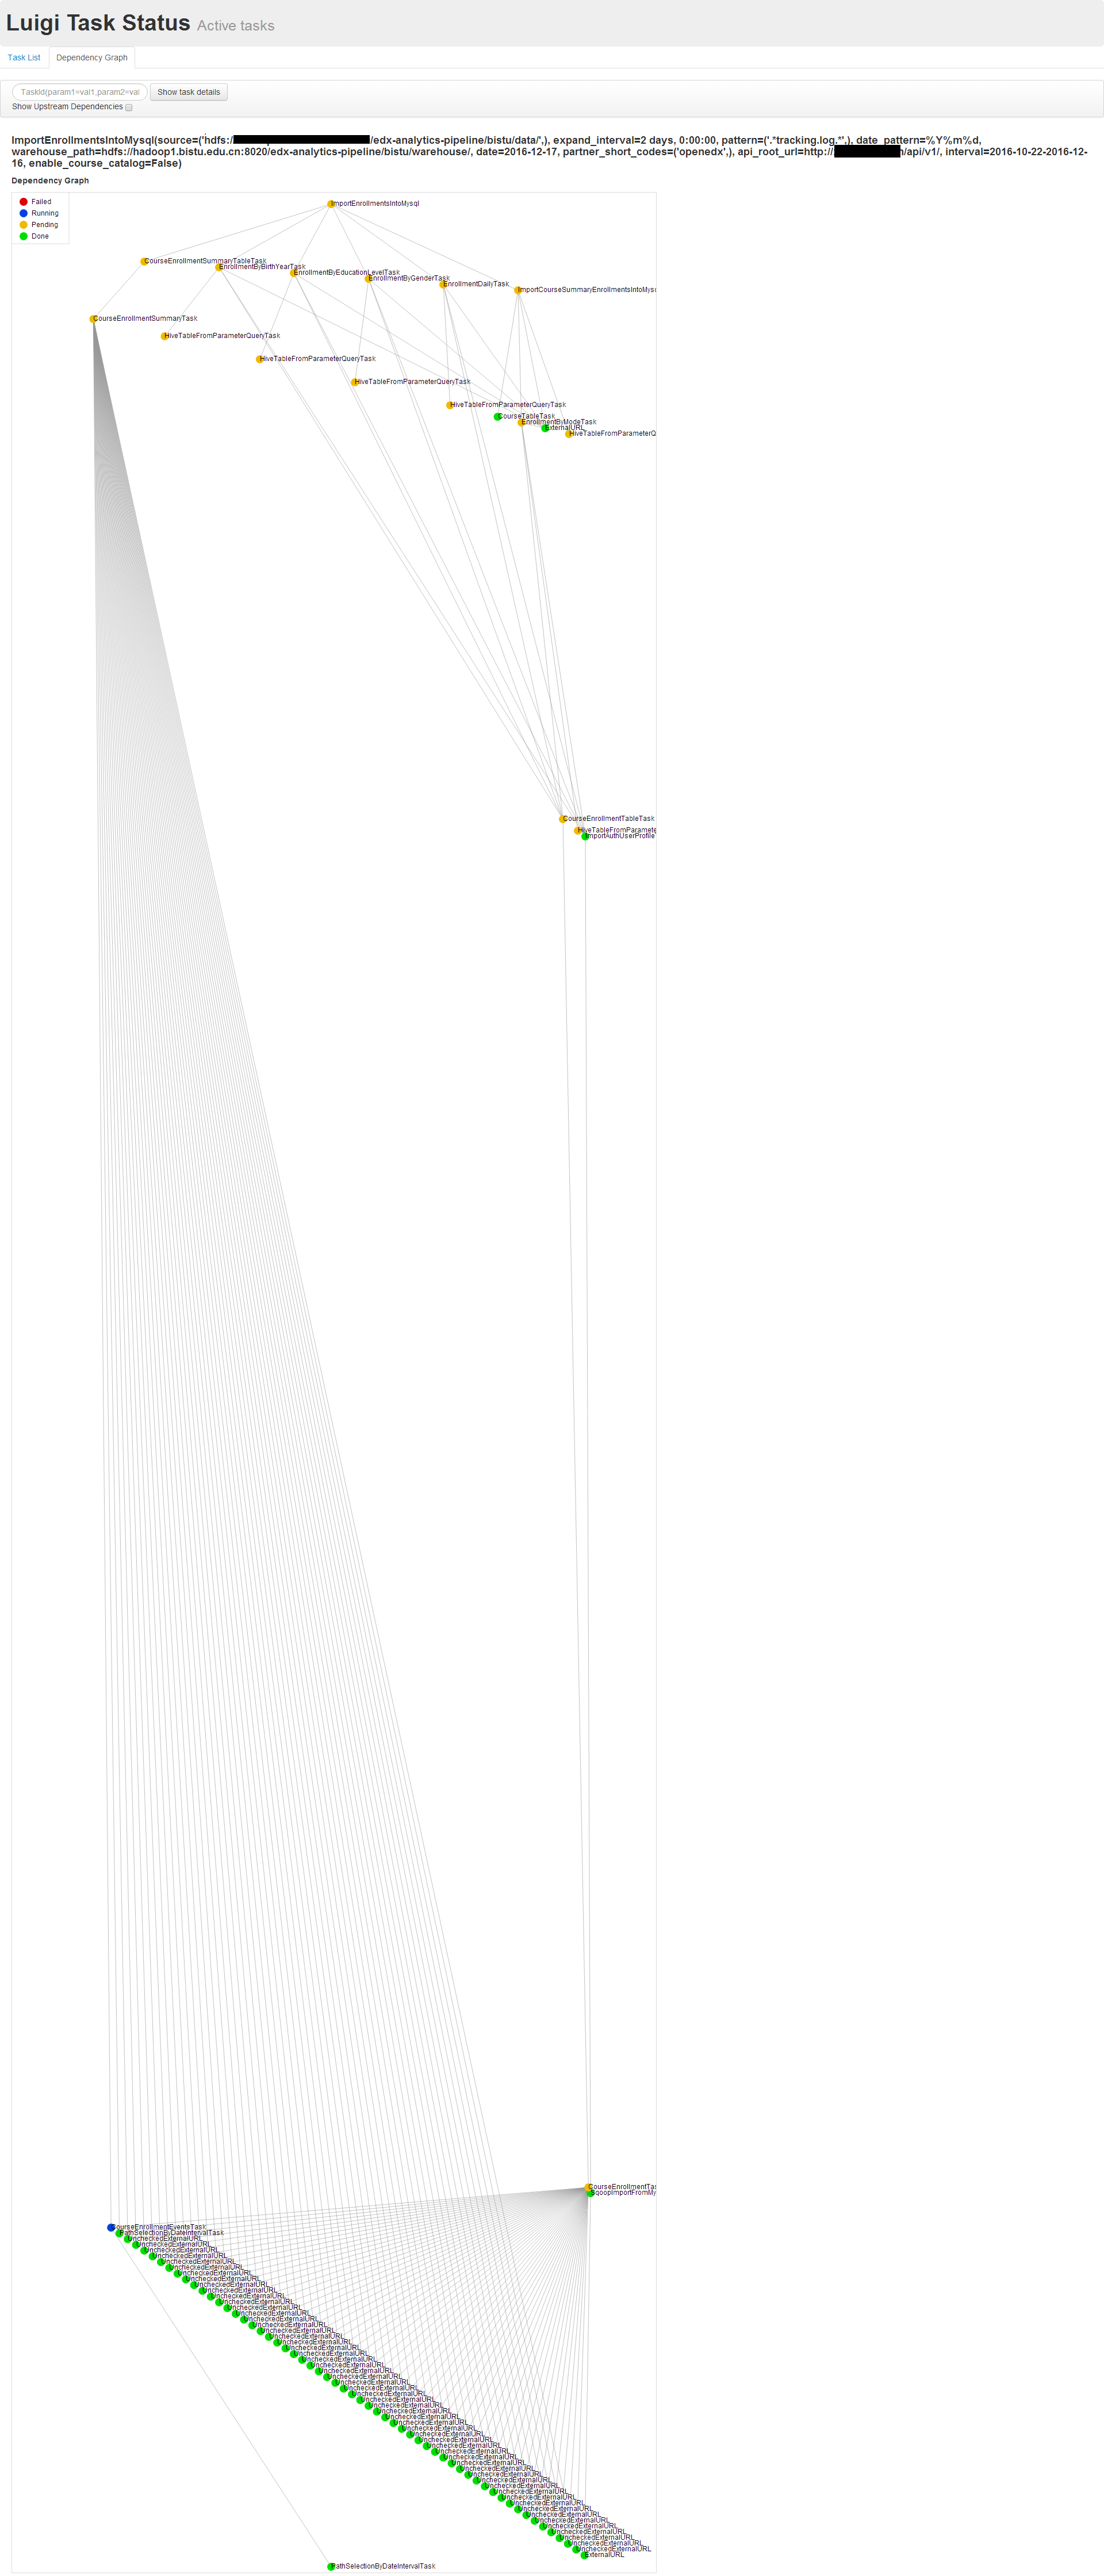
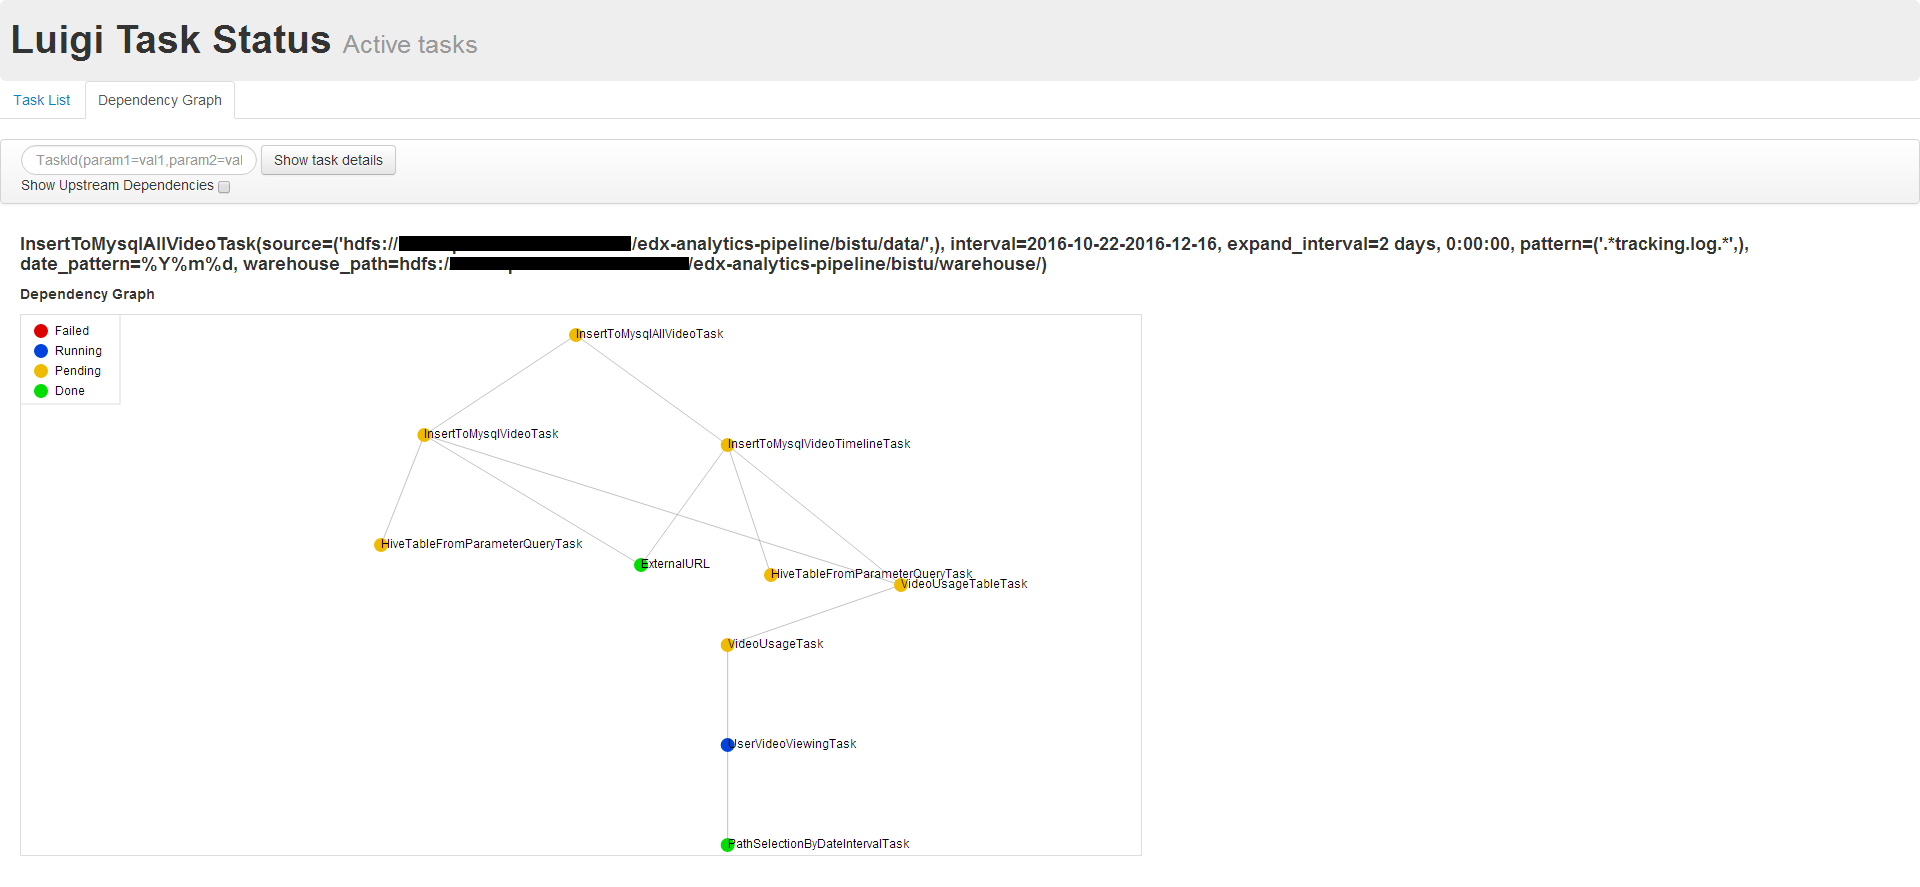
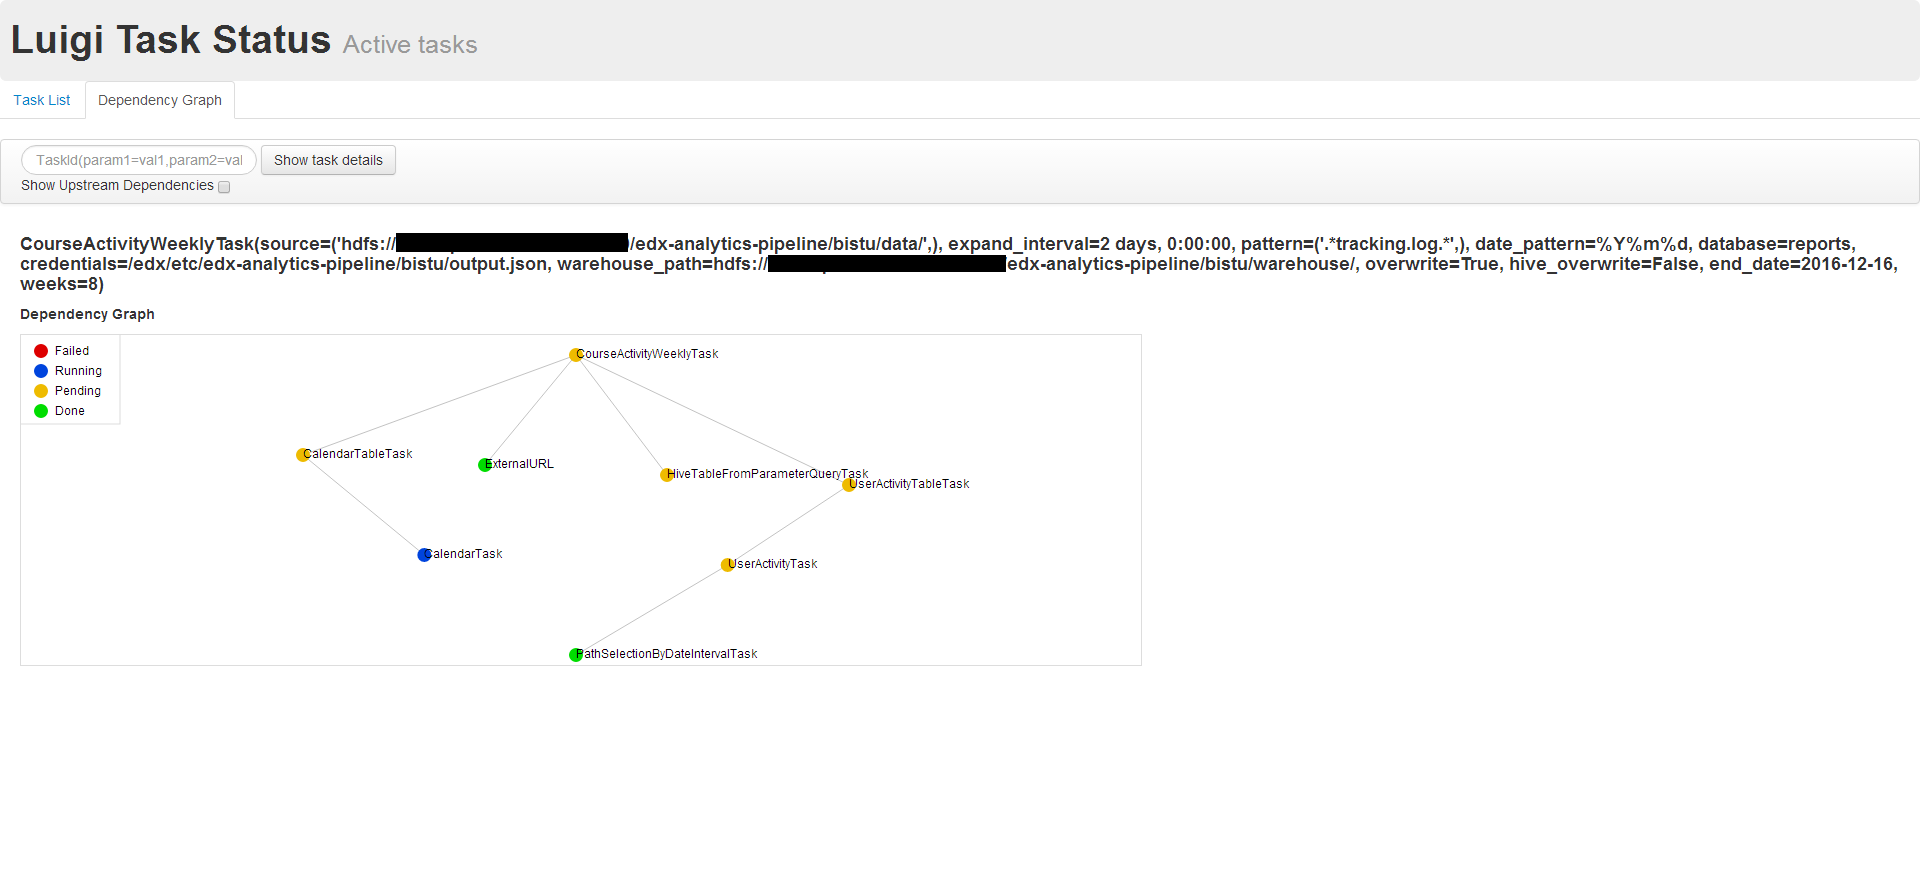
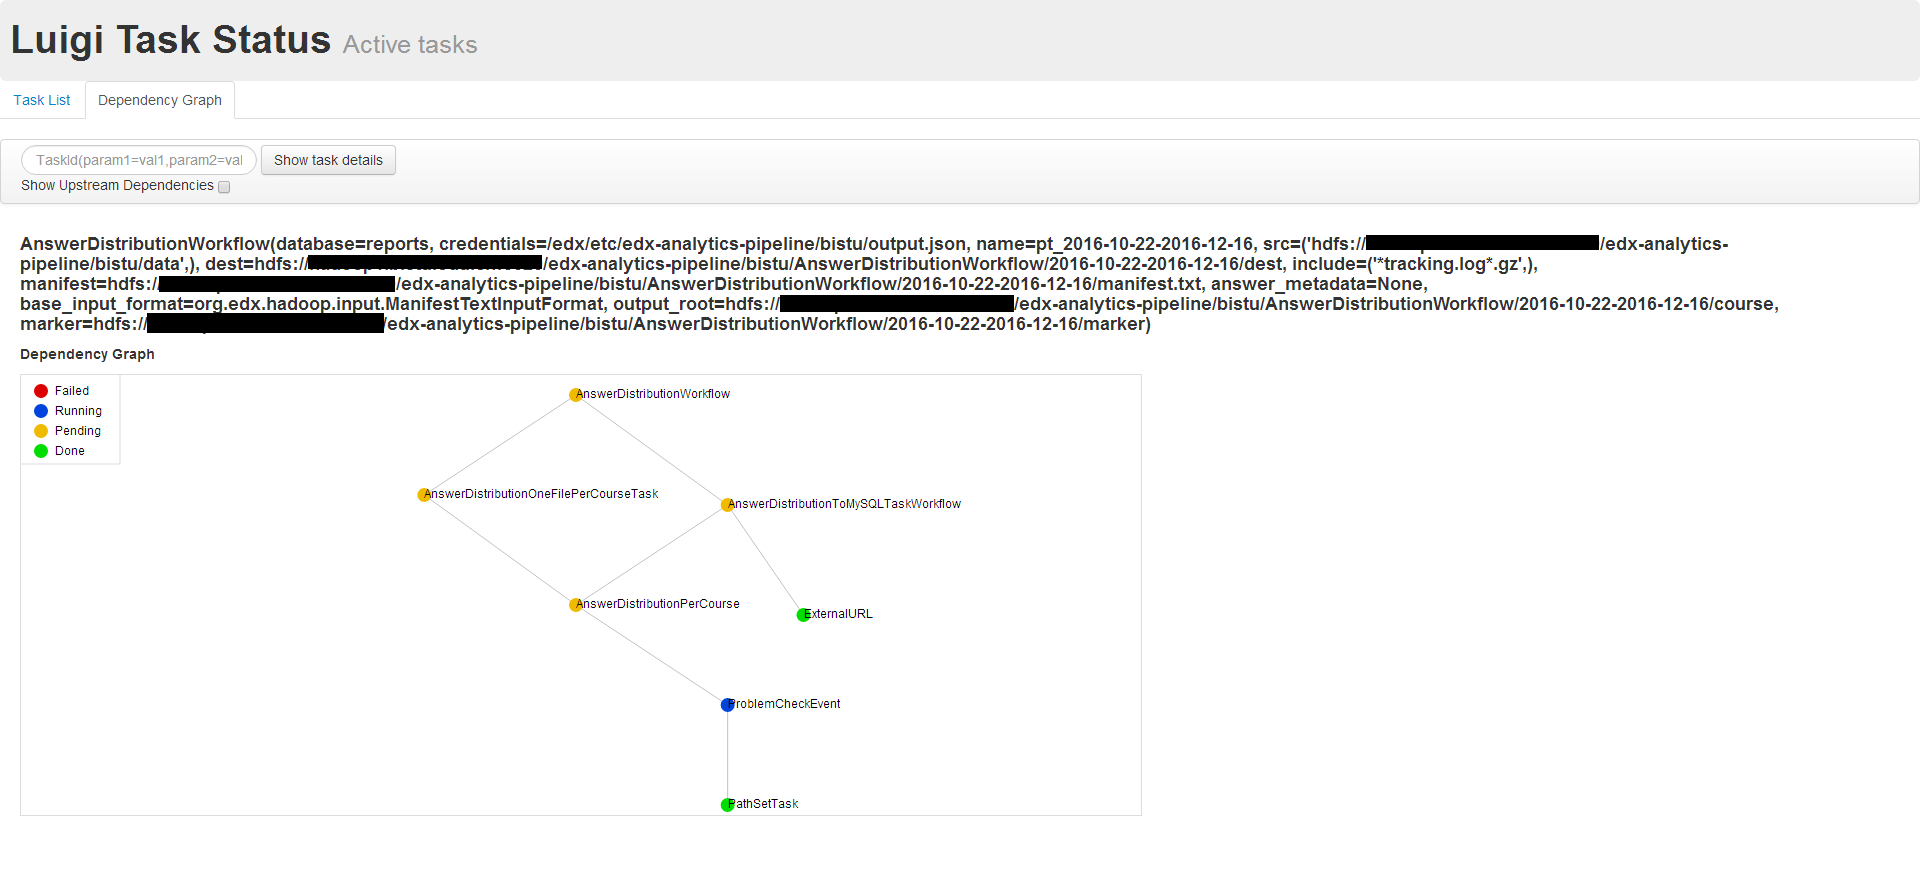
利用luigi的可视化功能绘制了现在5个分析任务流的依赖关系。。。。话不重要、看图

由于insight的数据需要每天同步,所以需要每天定时同步日志到集群的HDFS。所以写了个简单的脚本进行同步。脚本如下
前提是配置好ssh免密码
由于要在集群上操作配置、并且即将搭建一个新的集群,所以我不想再像之前一样复制粘贴命令了!!会死人的。。。
so,看了下ansible,
环境:Ubuntu 14.04主机*6
六台服务器运行的命令相同
(前提:已经做完root密钥互信)
安装:
sudo apt-get install ansible
配置:
sudo /etc/ansible/hosts
添加进去所有
# CDH搭建、配置(待填坑)
# 角色分配设计(待填坑)
# 参数调优(待填坑)
因为要把edX中Insight的数据导入到一个6节点集群中做运算,所以尝试分离pipline,远程执行分析任务。具体过程有时间另写文章分析(先挖个坑)=-=
今天发现luigi调度任务的时候把任务挂起后就不