1.注册花生壳账号。http://hsk.oray.com/
2.登录路由器配置界面。
3.绑定虚拟机网卡MAC和IP。
4.添加转发规则,把3389端口转发到外网。
5.配置花生壳账户,启用DDNS。
6.把自己的子域名加CNAME解析记录指向花生壳的动态域名。
7.更改虚拟机网卡设置,改成桥接模式
More.....
1.注册花生壳账号。http://hsk.oray.com/
2.登录路由器配置界面。
3.绑定虚拟机网卡MAC和IP。
4.添加转发规则,把3389端口转发到外网。
5.配置花生壳账户,启用DDNS。
6.把自己的子域名加CNAME解析记录指向花生壳的动态域名。
7.更改虚拟机网卡设置,改成桥接模式
终于可以开始填这个坑了233333
————————————
像上一篇文章说的数据结构要解决的问题是数据如何在内存中存储,以什么结构存储。
用张仰森老师的话来说,就是“数据以及数据之间的关系。”
今天主要要聊的就是线性结构。
这里说的
为了增加pipeline的运算速度,所以利用集群来进行日志的分析统计。测试数据规模:某机构edX的D版在真实场景下一年多使用记录。
开始日期 2016/11/27
开始时间 2:26:00
结束日期 2016/11/28
结束时间 3:34:00
总时间 23:10:54
日志开始日期 2015/6/7
日志结束日
是的=-=我又来挖坑了。。争取慢慢填233333
本文记录Ubuntu Linux下比较好用的软件
软件大部分可以通过apt-get install命令安装,如果你在校内,建议更换清华源(参考基本配置:http://blog.hylstudio.cn/archives/452),如果在校外可以用网易源。
之前还几篇可以参考。。之后会写的更详细的=-=嗯,相
本次搭建CDH主要用于edX的数据分析,用于安装pipeline加快运算速度。
3+N结构,3台主机负责HDFS主节点、CDH自身服务、YARN的ResourceManager等主要服务。 其他N台负责HDFS的NameNode和YARN的NodeManager,承担计算任务。现初步设计为6台、即3+3
CPU:双核E5
计科的同学做实验如果需要分词可以试用下这个分词引擎。
github地址https://github.com/huaban/elasticsearch-analysis-jieba
es官方文档https://www.elastic.co/guide/en/elasticsearch/reference/2.3/getting-started.html
地址http://es.hylstudio.cn/jieba
接口说明
返回json中的index
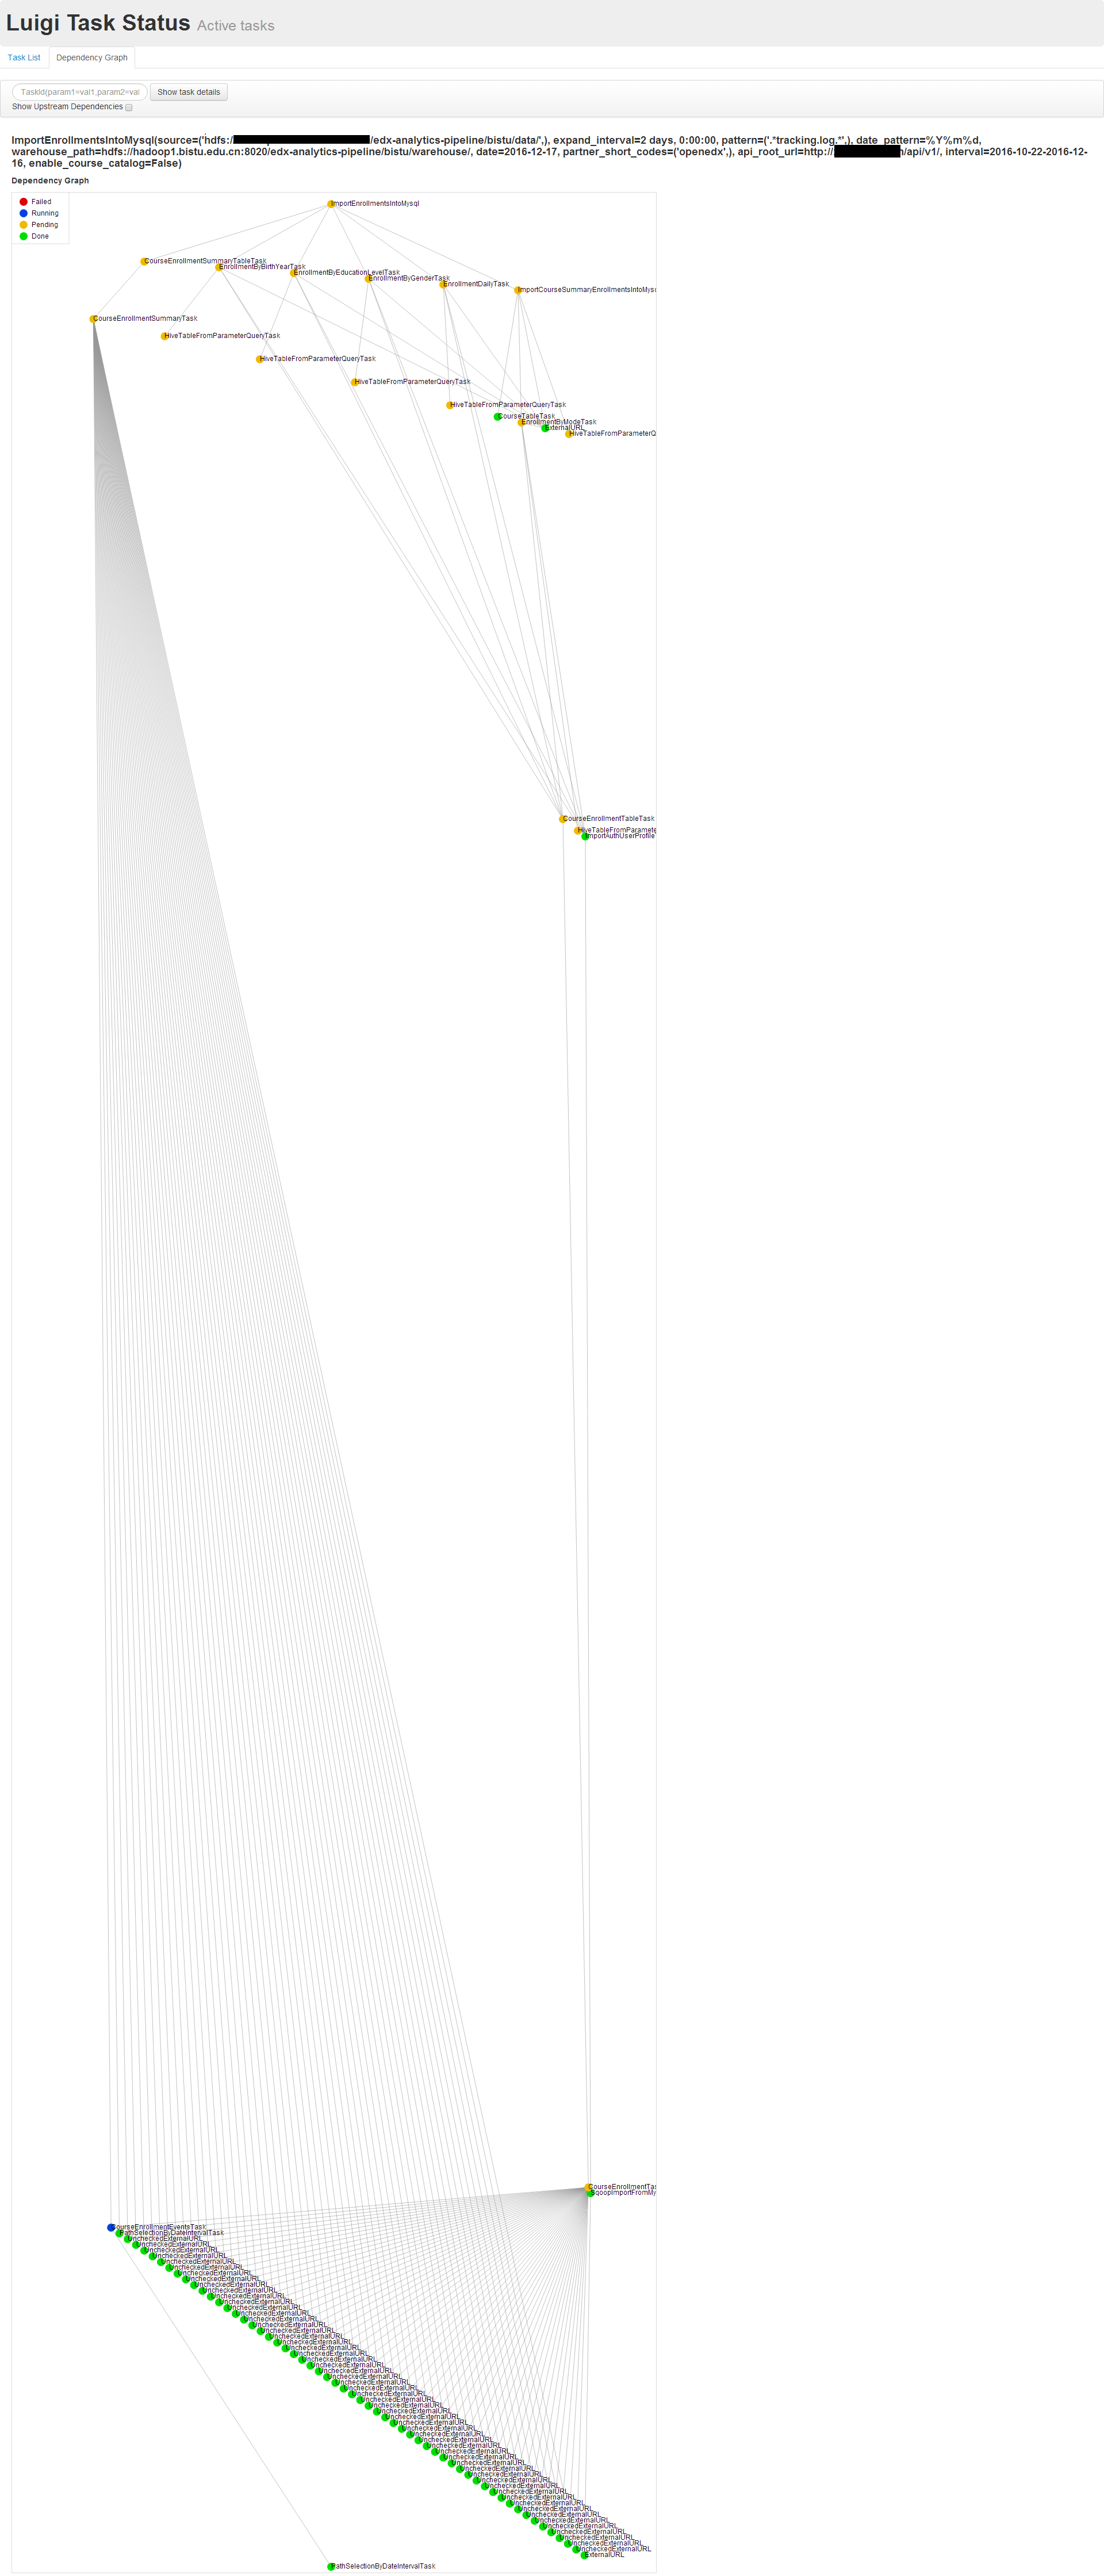
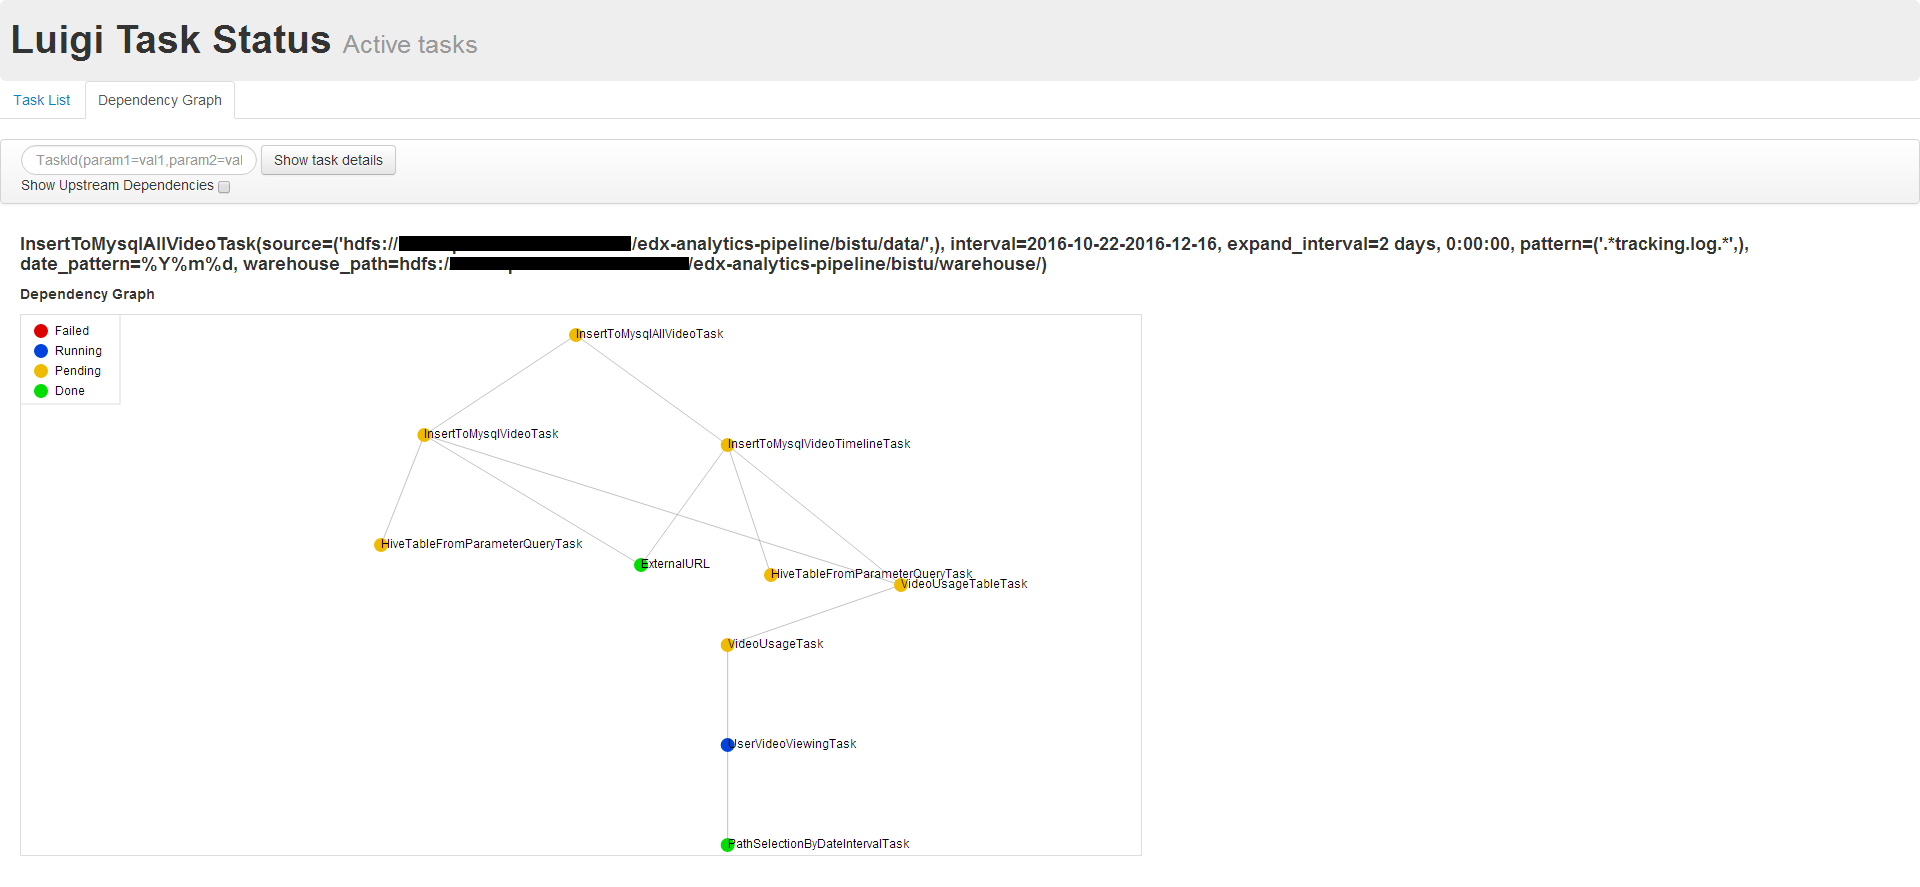
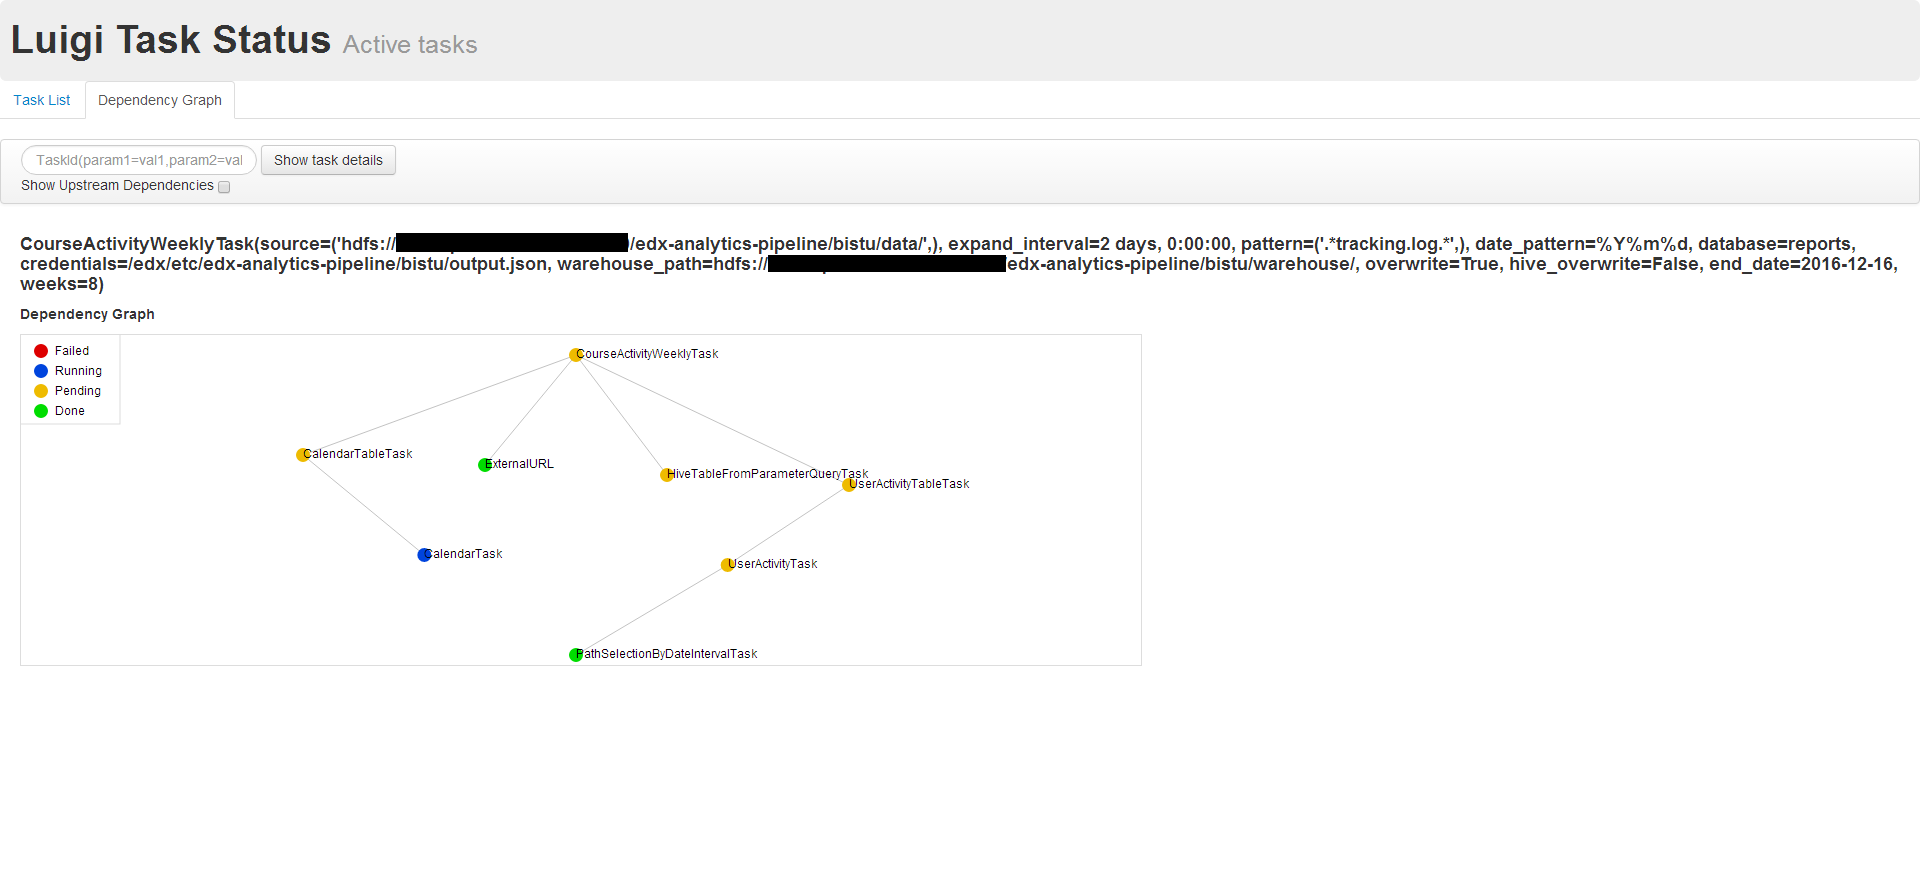
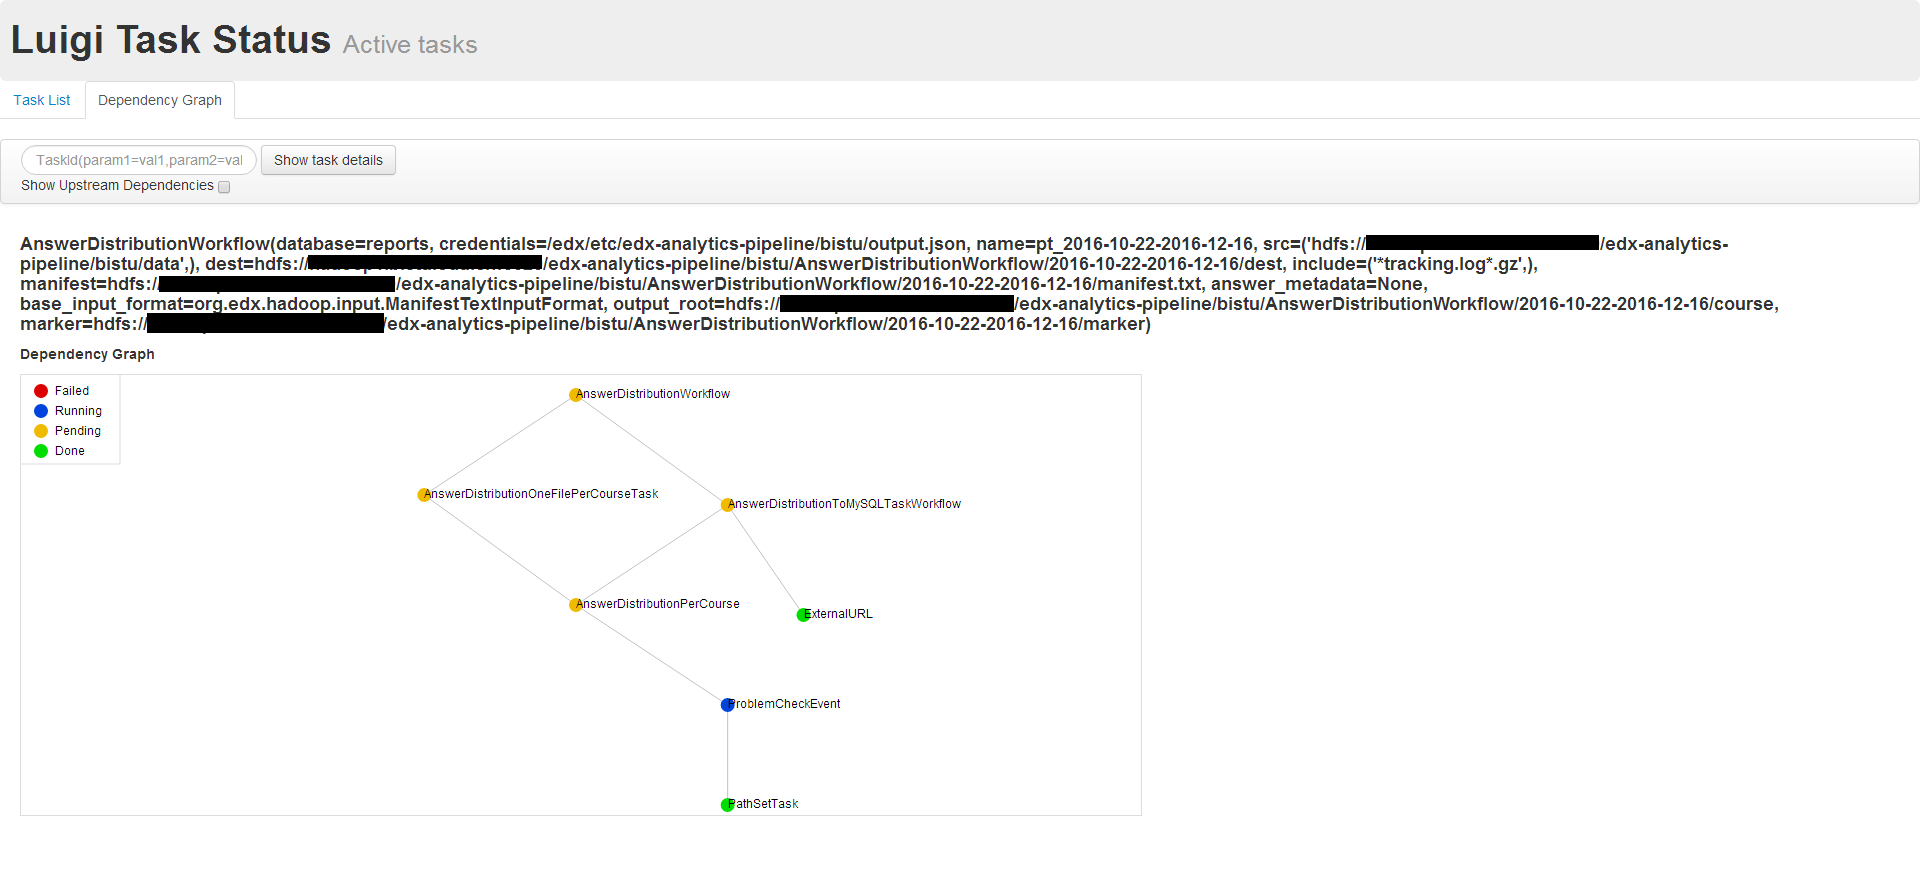
利用luigi的可视化功能绘制了现在5个分析任务流的依赖关系。。。。话不重要、看图